物理层、数据链路层、网络层
物理地址(MAC)
每个物理地址都是全球唯一的,出厂时就预设定好的唯一标识。
集线器
想想最初两台设备之间要互联,怎么做?在两台设备之间连上一根网线。三台设备之间互联呢?两两之间连上一根网线。问题来了:设备稍微一多,每台设备都需要接出去N个网线,怎么解决?
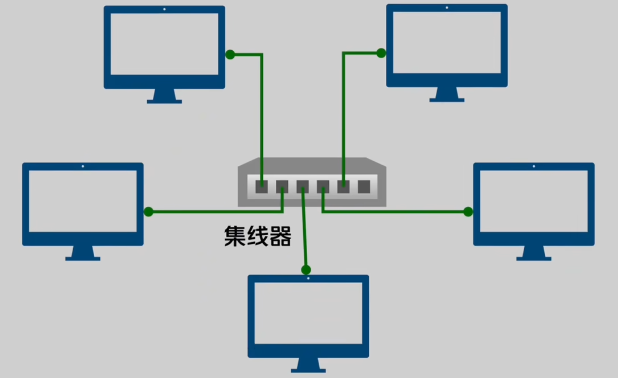
需要一台中转的机器,所有的设备都接一根线到这个中转机器上,这样就避免了每台电脑开N个网口,这个中转的机器就叫集线器。
但是集线器只会广播消息,并不能点对点传输,连接到同一台集线器上的设备只能通过消息的目标mac地址判断是否是发给自己的。因此升级版来了——交换机
交换机
交换机内部维护一张mac地址表,每次收到数据时,都会根据数据里的源mac地址,记录下这个端口(接线端口)对应的mac地址,下次如果有数据发送到这个mac地址,那么交换机就只会从这个端口发出去。如果没有记录,那么交换机的行为和集线器是一样的——广播
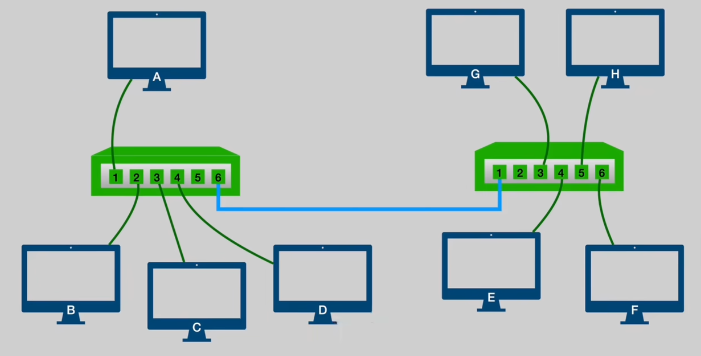
继续推演:随着电脑越来越多,单台交换机的端口也不够用了,怎么办呢?我们发现只要将多台交换机连接起来,问题仿佛解决了?想一下交换机内部维护的mac地址表是什么情况?交换机A连接交换机B的那个端口,需要将交换机B那边的设备的mac地址全部维护在这一个端口上。随着交换机组越来越多,这个mac地址表迟早有一天不够用。
路由器
路由器像一台电脑设备一样,有自己独立的mac地址(每个端口都有独立mac地址),可以帮交换机做一次转发。交换机之间不再直连,而是都接向路由器。这样交换机的mac地址表中这个接出去的端口,只需要记录这个路由器的mac地址就够了,只要能发给路由器,后续交换机就不管了。
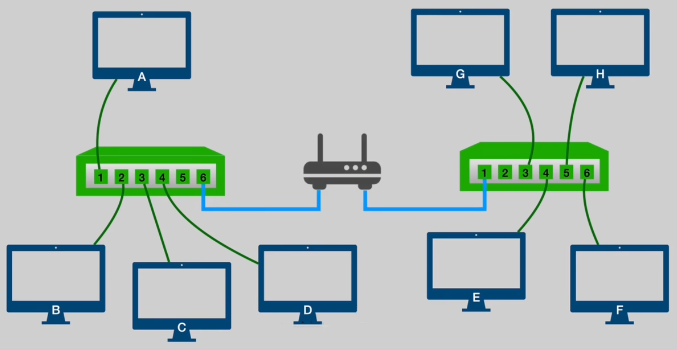
继续思考:现在的情况是,A设备发数据给B设备,要指定B设备MAC地址;A设备要发送数据给H设备,要指定路由器的MAC地址。问题是,A怎么区分这两种情况?到底是指定目标MAC地址还是路由器MAC地址?
思路:通过地址来区分这两类,比如左边设备地址统一XX开头,右边的设备地址统一是YY开头,那么A如果要发的设备MAC地址是YY开头的,就发给路由器。但MAC地址是出厂时就已预设好的,不可能随意更改。因此需要发明一种新的网络地址表示方法——IP地址
IP地址
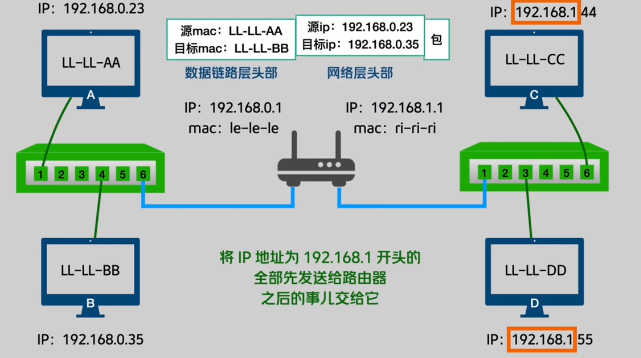
有了IP地址以后,凡是发送给192.168.0.x的数据,都直接由交换机发送,凡是发送给192.168.1.x的数据,都需要先发给路由器,如:
如果A发数据给B,目标mac和目标IP都写B的即可。(不经过路由器,与网络层无关)
如果A发数据给C,则目标IP为C的IP,目标MAC为路由器的MAC。路由器收到数据以后,可以根据目标IP地址,把目标MAC改为实际的MAC地址,然后把数据发出去,通过另一个交换机成功发送给C。
子网掩码
我们将左边的IP都是192.168.0.的称为同是一个子网,右边的IP都是192.168.1.的是另外一个子网。通过上面的介绍,我们人倒是很好理解,前多少位相同的是一个子网,但是对于计算机来说,怎么表达这个意思呢,必须得有一个算法——子网掩码。
例子中的子网掩码即为 255.255.255.0,具体算法就是将源IP与目的IP分别与子网掩码做与运算,结果为各自的网络号。若结果相同则为同子网,反之则为不同子网。
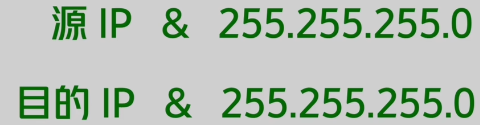
子网掩码就是用来计算,这个消息是否应该发送给路由器,仅此而已。
默认网关
新的问题:A怎么知道哪个设备是路由器?——默认网关
默认网关是一个IP地址,需要在A上进行设置,也就是告诉A,当遇到不在同个子网的IP时,先把数据发给这个IP地址(路由器的IP地址)。
注意:我们发数据给默认网关,并不会把目标IP写成默认网关,而是通过默认网关获取路由器的MAC地址(ARP协议),将目标MAC写成路由器的MAC。
ARP协议
这里我们回到最开始的场景,同个子网内,A发数据给B,如何知道B的MAC地址呢,其实也是通过ARP协议,由IP地址获取MAC地址的机制,从而在A电脑内部维护一个arp缓存表。
总结
电脑视角
我需要知道目标是否与我在同子网(子网掩码与运算)
我需要知道目标mac地址(ARP协议)
在同个子网就通过交换机直接发出去
不在同个子网就发给路由器
交换机视角
我收到的数据必须要有源MAC地址和目标MAC地址
源MAC地址用来维护自身的MAC地址和端口的映射关系(MAC地址表)
通过MAC地址表查目标MAC地址的端口映射关系,确认通过哪个端口发出去
查不到映射关系时,就所有端口都发出去
路由器视角
我收到的数据必须有目标IP地址
通过路由表查IP地址的映射关系
查到映射关系,就修改目标MAC地址,从对应端口转发出去
查不到映射关系,就返回路由不可达
传输层(网络是怎么可靠的)
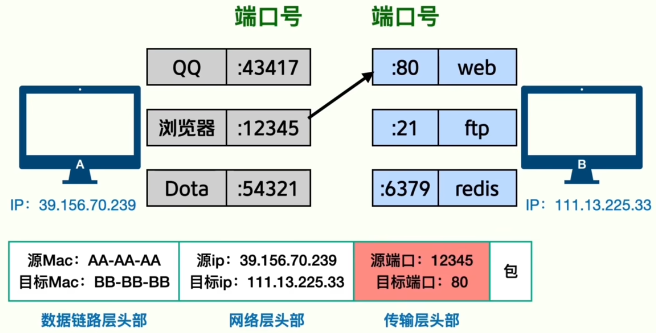
通过前面的三层结构,我们已经可以保证把数据从某个电脑A发送到某个电脑B。但是实际电脑中的应用程序是很多的,具体应该由哪个程序来处理这个发送的数据或者接收到的数据呢?我们给不同的应用程序分配不同的端口号,用来区分不同应用程序的数据。有了端口号之后,现在就由主机到主机之间的通信升级到了进程与进程之间的通信。
停止等待协议(可靠交付)
现在数据可以发送了,但是网络环境的复杂导致数据不一定能最终到达。A发送数据给B,如果包丢了怎么办呢?需要回答以下两个问题
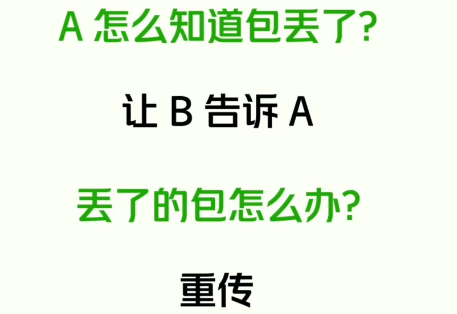
如上,很简单粗暴的解决办法。为了保证可靠性,A每次发一个数据包给B,都必须收到B的一个确认消息(ACK)才能继续发送,否则就要重复传同个包。
累计应答
但是这样效率太低,因此进行了以下改进:A一次性可以发多个包给B,并在每个包上都增加了一个序号(seq),B在给A回复ack时,也回应对应序号的ack(seq+1),这样不仅解决了效率问题,也解决了不同的数据包没有按顺序到达接收方的顺序问题。同时如果B发送的ack为4,不仅等于收到了3号包,同时表示1、2号包也收到了,这种方式解决了对1、2号包的ack可能丢包的情况(累计确认/累计应答)。
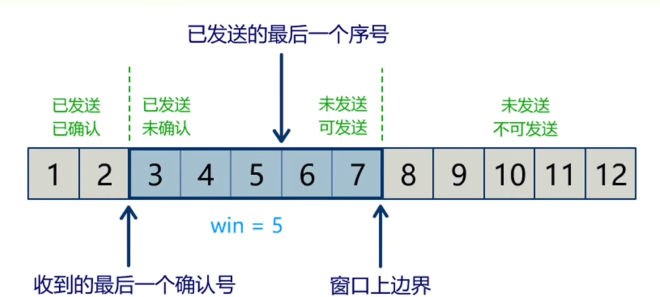
流量控制:滑动窗口机制
A和B每次发数据包时,都携带自身能接收的最大信息量,对方在发送数据时,就不能超过这个最大信息量。
窗口大小可实时调整
流量控制 vs 拥塞控制
归纳
物理层、数据链路层、网络层解决了怎么把包发到目的地,但是不能解决数据包传丢、传乱、传慢、传快的问题,以及对方有没有准备好传输数据。传输层解决的就是这部分问题。
通信加密(网络是怎么安全的)
想象最初,A给B传输一段消息,这段消息在路上每个节点都能被看到,毫无隐私。
最直观的方法就是加密通话,像谍战片里的密码本一样,A和B手里都有密码本就可以进行加密通话,这就叫做对称加密。
问题是很多情况下,A和B之间并没有相同的密码本,就需要B生成一个密码本发给A,这个密码本也是需要在网络上传输的,如果被中间节点看到,也就不安全了。为了保证对称加密的安全性,在对称加密外套一层非对称加密:A有一对密码本M、N,这两个密码本很神奇,通过M加密的数据,必须用N才能解密,反之亦然。A把其中的M保留在本地不让其他人知晓(称其为私钥),将N通过网络传输给B(在网络上是公开的,称其为公钥),B通过公钥N给自己的对称加密密钥(密码本)加密,然后再发送给A,A收到消息后通过私钥M解密读取消息。这样中间节点由于没有私钥M,就无法解密读取其中的消息,消息就安全了。(防偷看)
但是这个公钥N仍然是明文传输,虽然中间人无法偷看消息,但可以伪造公钥:A向B传输公钥N时,中间人扣下公钥N,并伪造了一对私钥m和公钥n,将伪造的公钥n发送给B。
B通过公钥n加密对称密钥后,发送给A,中间人通过m解密读取对称密钥,然后再将对称密钥通过扣下来的公钥N加密传给A。
A收到B的对称密钥后,解密正常。也就在A和B毫无察觉的情况下窃取了消息,这就叫中间人攻击。(不能防篡改公钥)
为了保证公钥传输的安全,再套一层私钥X、公钥Y:A用私钥X加密公钥N后发送给B,B通过公钥Y解锁获得公钥N……等一下,这样的话问题到了公钥Y身上了,公钥Y还是得网络明文传输,只有通信双方这样一层套一层是解决不了问题的,最外面一层的公钥始终都是不安全的。因此需要引入第三方机构。
引入第三方机构——CA。CA其实就是一个公认的可信度第三方,将第三步中私钥X和Y交给CA来负责。也就是让CA用他的私钥X加密A的公钥N,然后B用CA的公钥Y解密得到公钥N,为什么这样就可行了呢?因为B可以对CA的公钥Y进行验证,中间人随意伪造的公钥不可能与CA的公钥相同,而A创造的公钥,B是没有办法验证的。这样就可以防篡改。
注:这套安全壳就是HTTPS